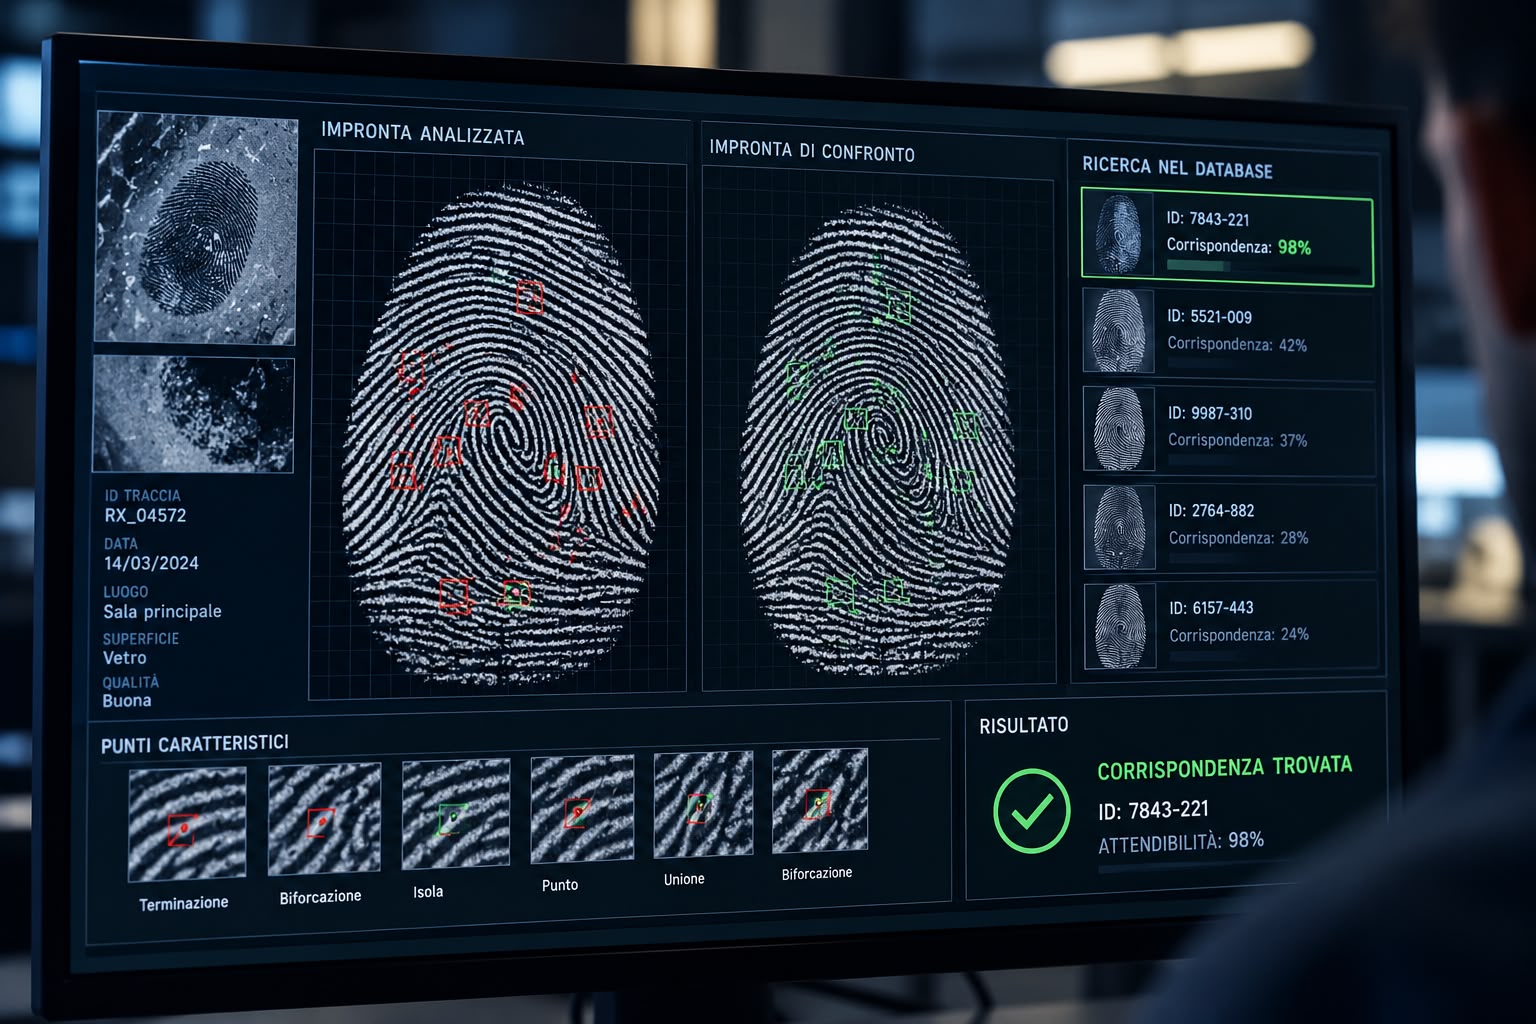
«Abbiamo trovato un’impronta.»
«È utilizzabile?»
«Non è completa. Ci sono diversi punti poco leggibili, ma quelli che ci interessano sembrano abbastanza nitidi.»
«Confrontatela con il database.»
«Ci stiamo lavorando. Se troviamo una corrispondenza, sapremo chi stiamo cercando.»
«E se non la troviamo?»
«Dovremo cercare altri indizi.»
La scena potrebbe essere quella di una puntata di CSI. Un laboratorio, un monitor pieno di dettagli ingranditi, qualcuno che cerca una corrispondenza in un archivio. Pochi secondi di silenzio, poi una voce: «Ce l’abbiamo».
Ma proviamo a cambiare scenario. Niente scena del crimine, niente detective e nessuna persona da identificare. Siamo in un locale, parte una canzone che non conosciamo e tiriamo fuori il telefono. Apriamo Shazam, aspettiamo qualche secondo e sullo schermo compare il titolo del brano.
Che cosa hanno in comune le due situazioni? Apparentemente poco. Eppure, il principio del confronto è sorprendentemente simile. Per capirlo, dobbiamo prima capire come trasformare qualcosa di complesso in una serie di caratteristiche utili per un’identificazione.
Il suono diventa un’immagine
Una registrazione musicale rappresenta un segnale che varia nel tempo. Possiamo visualizzarlo come una forma d’onda, ma quella linea, da sola, ci dice poco di ciò che accade dentro un brano. Una voce, una chitarra, un basso e una batteria convivono nello stesso segnale, con frequenze che si sovrappongono e cambiano in continuazione.
Per osservare meglio questa complessità possiamo ricorrere alla trasformata di Fourier, uno strumento matematico che permette di analizzare le componenti in frequenza di un segnale.
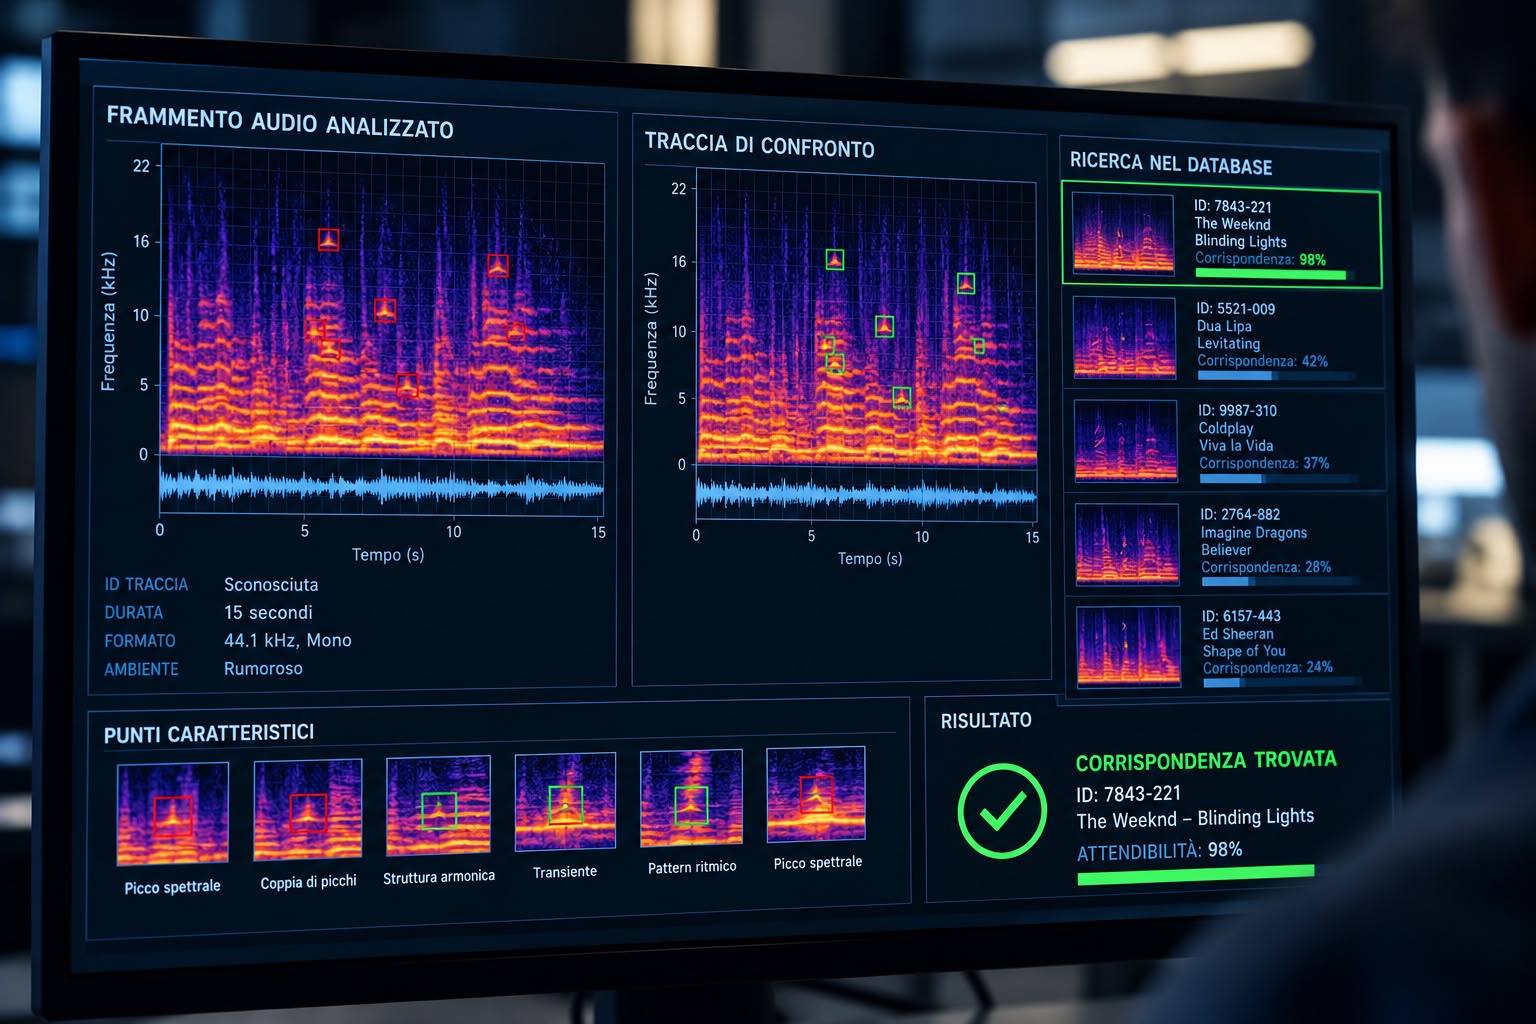
Applicando l’analisi a brevi intervalli successivi, otteniamo uno spettrogramma: un’immagine in cui il tempo scorre in orizzontale, le frequenze sono disposte in verticale e l’intensità delle componenti viene rappresentata attraverso variazioni di luminosità o colore.
A guardarlo, sembra quasi una città vista dall’alto di notte. Alcune componenti emergono con chiarezza, altre restano sullo sfondo; linee e macchie si intrecciano formando una trama che cambia continuamente. Non è una partitura e non ci dice direttamente quali note stiano suonando. È una rappresentazione di come l’energia sonora si distribuisce tra le frequenze e nel tempo.
E proprio questa trama, che a un primo sguardo può sembrare caotica, contiene informazioni preziose.
Cercare gli indizi
Immaginiamo di avere davanti lo spettrogramma di una canzone. Dobbiamo confrontarlo per intero con milioni di altri? Non esattamente. Sarebbe un po’ come cercare una persona confrontando ogni singolo dettaglio del suo volto con quello di tutti gli abitanti di una città.
È molto più efficace individuare alcuni punti caratteristici e studiare le relazioni tra loro.
È il principio dell’audio fingerprinting, l’“impronta digitale” di una registrazione. Nel metodo descritto da Avery Wang per Shazam, si selezionano picchi locali nello spettrogramma: punti che emergono rispetto alle componenti vicine. Non si tratta necessariamente dei suoni più forti in assoluto, ma di caratteristiche che possono rimanere riconoscibili anche in presenza di rumore.
Il singolo punto, però, racconta poco. Diventa interessante sapere dove si trova rispetto agli altri: a quale frequenza e a quale distanza temporale da un altro picco.
Combinando le frequenze di una coppia di picchi e l’intervallo di tempo che li separa si genera un codice compatto, chiamato hash. L’insieme di molti codici costituisce un’impronta che può essere confrontata rapidamente con quelle già archiviate.
Ed è qui che torna utile il paragone iniziale. Come nelle impronte digitali, non è necessario che ogni dettaglio sia perfettamente leggibile: conta trovare una combinazione di caratteristiche abbastanza distintiva da consentire un’identificazione.
Naturalmente, il software non sovrappone semplicemente due immagini per vedere se coincidono. Utilizza dati matematici ricavati dai picchi e dalle loro relazioni.
Il confronto con l’archivio
Un’impronta, da sola, serve a poco se non abbiamo nulla con cui confrontarla. Per riconoscere un brano, il sistema deve disporre di un archivio contenente le caratteristiche delle registrazioni già analizzate.
Quando premiamo il pulsante di Shazam, il sistema acquisisce un frammento audio e ne estrae le caratteristiche. Queste vengono confrontate con quelle conservate nel database.
Possiamo immaginare l’archivio come un enorme schedario, con milioni di impronte al suo interno. La ricerca non consiste nel confrontare una canzone alla volta nella sua interezza, ma nel recuperare rapidamente le registrazioni associate agli stessi codici.
C’è poi un dettaglio fondamentale: le corrispondenze devono essere coerenti anche nel tempo. Se alcuni punti coincidono per caso, ma le loro posizioni temporali non tornano, potrebbero non significare nulla. Se invece molte corrispondenze indicano lo stesso scarto tra l’inizio del frammento e la sua posizione nel brano completo, l’ipotesi che si tratti della stessa registrazione diventa molto più convincente.
Il sistema non deve quindi ricostruire tutta la musica, né isolare perfettamente ogni strumento. Deve trovare abbastanza indizi affidabili da risalire alla registrazione giusta.
Un’impronta per ogni canzone?
Non proprio. O meglio, dipende da cosa intendiamo per canzone.
Una stessa composizione può esistere in molte versioni: una registrazione in studio, un’esecuzione dal vivo, un remix o una reinterpretazione al pianoforte. Per noi possono essere tutte versioni dello stesso brano. Per un sistema che confronta le caratteristiche acustiche, però, possono essere registrazioni molto diverse.
Questo metodo è particolarmente efficace quando si tratta di riconoscere una registrazione già presente nell’archivio, anche se il frammento acquisito è incompleto o disturbato. Riconoscere una melodia indipendentemente da come viene suonata è un problema differente, che richiede tecniche diverse.
La cosa interessante è che, per identificare una registrazione, un computer non deve necessariamente capire la musica come la capiamo noi. Non deve sapere se un accordo è maggiore o minore, se il cantante è intonato o se quel giro di basso è particolarmente riuscito. Deve individuare una combinazione di caratteristiche sufficientemente distintiva.
Come in una scena del crimine, un singolo indizio può non significare molto. Ma quando diversi indizi coincidono e si trovano al posto giusto, il quadro comincia a prendere forma.
E la prossima volta che Shazam riconoscerà una canzone in pochi secondi, sapremo che dietro quel risultato apparentemente immediato c’è stato un piccolo lavoro da scientifica.
«E anche questo caso l’abbiamo risolto.»
Francesco Grammatico
Per approfondire: Avery Li-Chun Wang, An Industrial-Strength Audio Search Algorithm (ISMIR, 2003). L’articolo illustra il principio dell’audio fingerprinting descritto in questo lavoro. Le immagini fornite sono illustrative e non mostrano l’interfaccia reale di Shazam.